Вывод: Вариант B лучше варианта A — конверсия выше на 30%
13% против 10% ещё не победа
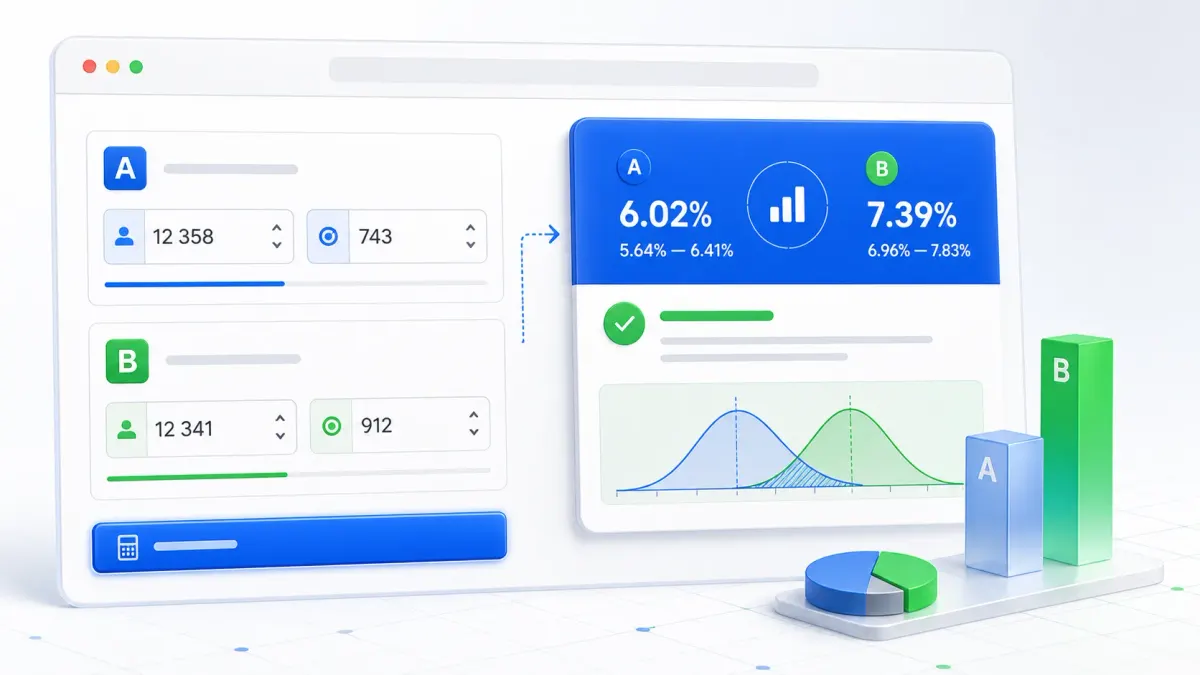
Конверсия — это оценка по конкретной выборке, а не точное свойство варианта. Соберите ту же тысячу посетителей ещё раз, и цифра слегка сдвинется. Доверительный интервал показывает, в каком диапазоне на самом деле лежит истинная конверсия. Значимость отвечает на другой вопрос: могла ли разница между вариантами получиться просто из-за случайности выборки.
Ширина интервала зависит от выбранного уровня доверия. За ним стоит критическое значение z, и чем выше уверенность, тем шире интервал:
| Уровень доверия | Значение z | Что означает |
|---|---|---|
| 80% | 1,282 | грубая прикидка, ошибётесь в каждом пятом случае |
| 90% | 1,645 | мягкий порог для быстрых решений |
| 95% | 1,960 | стандарт по умолчанию в продуктовой аналитике |
| 99% | 2,576 | когда цена ошибки высока |
Повысить уровень доверия и не потерять в чувствительности можно только одним способом: набрать больше наблюдений.
Почему интервал Уилсона, а не «плюс-минус» на глаз
Обычное нормальное приближение (среднее ± z·стандартная ошибка) на низкой конверсии или маленькой выборке легко даёт нижнюю границу ниже нуля. Формула просто не знает, что доля не может выйти за эти пределы. Интервал Уилсона устроен иначе и всегда остаётся в границах 0–100%.
Разница между вариантами считается отдельно, двухвыборочным z-тестом пропорций. Это тот же метод, что и хи-квадрат тест, на котором построены большинство калькуляторов A/B-тестов, включая калькулятор Эвана Миллера. При трёх и более вариантах калькулятор сравнивает их попарно и поднимает порог значимости поправкой Бонферрони. Чем больше пар проверяется, тем выше шанс найти «значимую» разницу просто по случайности, если не ужесточить критерий.
Маленькая выборка обманывает чаще, чем кажется
Один и тот же прирост конверсии на 100 посетителях и на 10 000 значит разное. На маленькой выборке доверительный интервал широкий, и то, что выглядит как явная победа варианта, легко оказывается шумом. Останавливать тест по первому «значимому» результату не стоит. Дождитесь, пока выборка наберёт объём, достаточный для выбранного уровня доверия.